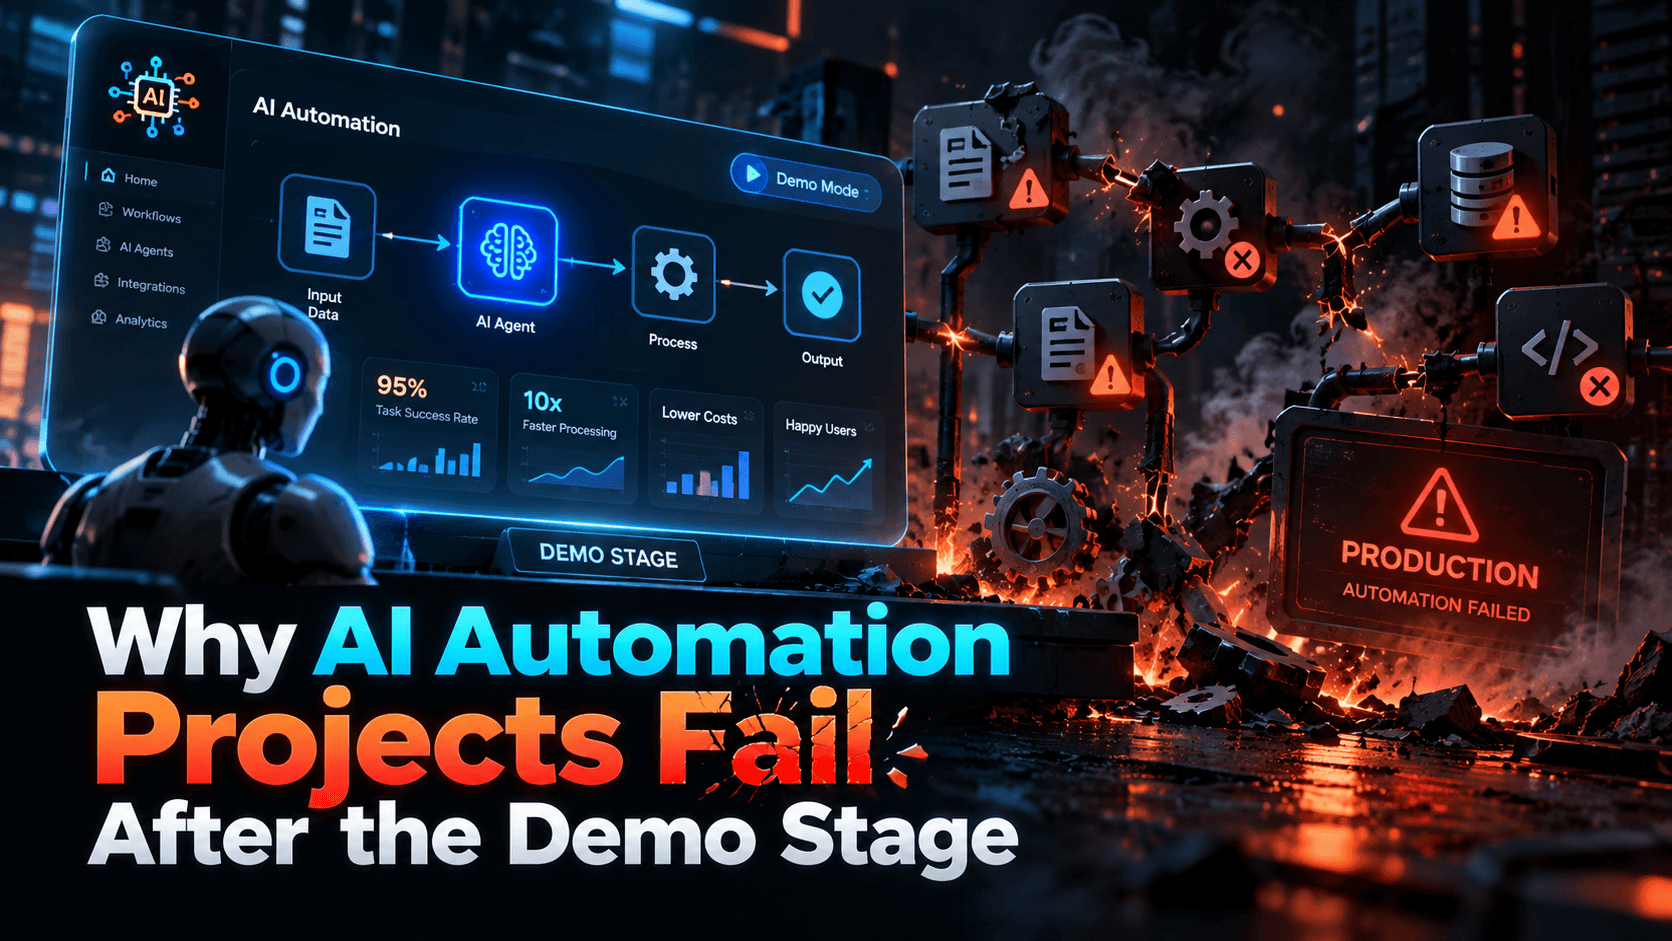
在受控的演示环境中,让 AI 自动化看起来令人印象深刻并不难。
表单进入系统,AI 理解内容,工作流运行,文档被生成,一切似乎都能自动完成。
但当系统真正进入生产环境后,情况就不同了。
真实客户可能提供不完整的信息,API 可能失败,员工可能使用不一致的术语,异常情况会出现,权限会变得复杂,有些操作还需要人工审批。
很多 AI 自动化项目正是在这里开始出现问题。
1. 演示使用的是理想输入
演示通常展示的是干净、规范的示例,但生产环境不是这样。
真实输入可能包含拼写错误、缺失字段、相互冲突的信息、非常规文件格式、重复请求、不清晰的说明,或不完整的客户数据。
如果工作流只有在输入完美时才能运行,那么它还没有达到生产就绪状态。
2. 工作流没有异常处理路径
引入 AI 往往正是因为工作流本身存在一定模糊性。
这意味着异常情况不是偶发事件,而是常态的一部分。
生产流程需要明确:什么时候 AI 可以自动继续,什么时候应要求补充信息,什么时候需要人工审核,什么时候应该停止流程,以及失败的操作应如何重试。
如果没有异常处理,自动化反而可能制造比它减少的更多运营工作。
3. 项目自动化了一个任务,而不是一个完整流程
生成回复只是一个任务。
完整的客户支持流程可能包括接收请求、识别客户、查看历史活动、分类问题、检索信息、起草回复、获得审批、发送回复、更新 CRM,以及记录最终结果。
如果 AI 只自动化了其中一个最显眼的步骤,那么整个工作流的改善可能非常有限。
4. 集成工作的复杂度被低估
AI 很少能在孤立状态下创造真正的业务价值。
它通常需要访问 CRM、电子邮件、文档存储、财务软件、帮助台、数据库、内部门户或项目管理系统。
每一次连接都会带来新的问题,例如身份验证、令牌过期、权限、API 失败、重复处理以及数据一致性。
演示可以隐藏这些问题,但生产环境不能。
5. 上线后没有人真正负责这个工作流
AI 自动化不是一次性安装后就可以不管的系统。
必须有人负责监控失败、更新提示词或规则、检查异常输出、关注使用成本、管理权限、衡量绩效,并应对上游软件变化。
如果没有明确的责任归属,小问题会不断积累,直到员工逐渐失去对这个工作流的信任。
6. 企业在简化流程之前就开始自动化
有些流程之所以低效,是因为底层工作流本身设计得不好。
在自动化之前,应先确认现有步骤是否全部有必要、同一信息是否被重复录入、审批是否重复,以及各方责任是否清晰。
通常,越简单的流程越容易实现可靠的自动化。
7. 项目选择了错误的自动化层级
并不是每个流程都需要自主 AI Agent。
有些工作流只需要一个触发器和几个确定性动作;另一些则需要条件分支、状态管理、工具调用或人工审批。
一个很有参考价值的资源是 NexusAi 的企业 AI 自动化工具指南。它把自动化区分为不同层级,从简单触发器、多步骤工作流,到企业级 RPA 和自主 Agent。
正确的自动化层级取决于流程本身的模糊程度和风险水平。
8. 上线前没有定义成功标准
一个演示只要成功运行一次,就可能被认为是“成功”的。
但生产系统需要可衡量的结果。
例如:
- 将响应时间从 4 小时缩短到 1 小时
- 减少 60% 的人工数据录入
- 将处理错误降低 30%
- 在不增加员工数量的情况下处理多 40% 的请求
- 减少团队之间的交接延迟
这些目标能够帮助企业判断自动化是否真正有效。
9. 把人工审核视为失败
有些团队认为,成功的 AI 自动化就意味着彻底移除人工参与。
其实通常没有这个必要。
更好的系统会把人工放在最能发挥价值的位置,例如审批高风险操作、处理异常案例、检查低置信度输出,或审查敏感决策。
Human-in-the-loop 设计可以在保留可靠性的同时,减少大部分重复性工作。
10. 生产环境需要可观测性
如果工作流静默失败,企业就无法有效管理它。
有用的监控指标可以包括:工作流运行状态、错误原因、验证结果、API 失败、处理时间、重试次数、人工审核比例,以及每次运行的成本。
企业应该能够快速理解发生了什么,而不需要手动重建整个工作流。
最后的思考
AI 自动化项目失败,并不是因为演示没有价值,而是因为演示通常只能证明一条“理想路径”是可行的。
真正的生产环境需要可靠的集成、清晰的责任归属、异常处理、监控、治理、真实输入,以及可衡量的业务结果。
最强的自动化项目,始终围绕真实工作在不完美条件下如何发生来设计。